
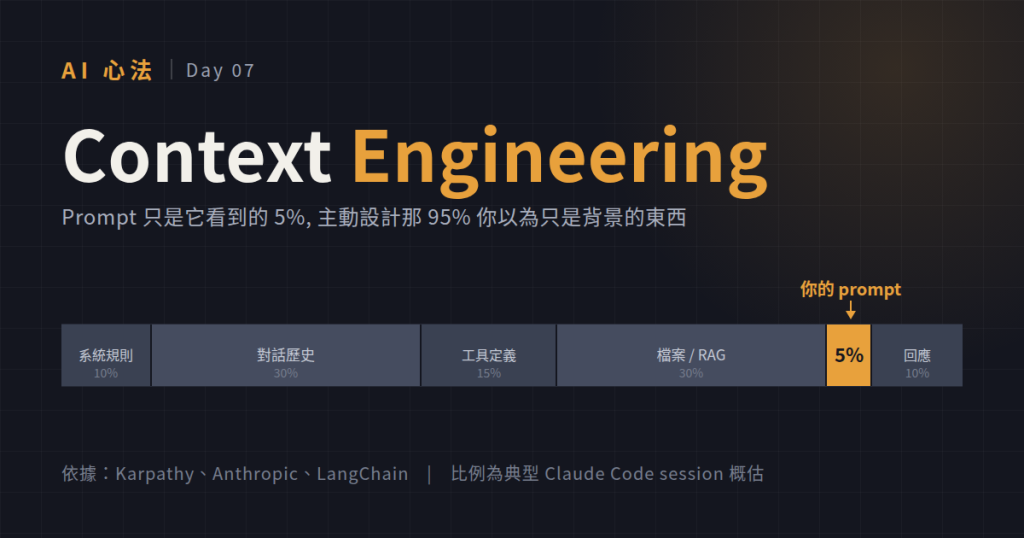
你打字送出的是那一句. 模型當下讀到的是整個 context window. Claude Code 一次呼叫大概長這樣:
| 塊 | 誰放進去的 | 大約佔比 |
|---|---|---|
| System prompt / CLAUDE.md | 你或工具預先寫好 | ~10% |
| 前幾輪對話 | 累積 | ~30% |
| 工具定義 (MCP) | 你安裝的 MCP server | ~15% |
你 @ 進來的檔案、Read 抓的檔案 |
每輪動態放 | ~30% |
| 你這一句 prompt | 你 | ~5% |
| 模型的思考 + 回應空間 | 保留給模型 | ~10% |
你動的那 5%, 只有 5% 的重量. Context Engineering 講的是其他 95% 你也可以主動設計. Karpathy 一句話點名: 「context engineering 是把 context window 填對這門手藝.」
模型答錯, 大部分不是「它變笨」, 是它看到的 context 不對. 三種偏法, 症狀不同:
| 偏法 | 症狀 | 原因 |
|---|---|---|
| Missing | 明顯資訊沒對到, 亂猜 | 該給的檔案沒 @ 進來, RAG 漏檢 |
| Overloaded | 拖越久答越糊, 忘記前面說過的 | Context 塞太滿, attention 被稀釋 |
| Poisoned | 一直沿用前面的錯誤假設 | 早輪的錯誤輸出還在對話裡, 每輪都被讀一次 |
第二種最不容易發現, 因為模型不會告訴你「我這輪注意力有點分散」. Anthropic 官方講白: context rot 是 transformer 架構本身的特性, 不是訓練沒做好. 這也解釋為什麼一次對話拖到 100K+ tokens, 結果通常很難用.
第三種你要學會辨識. 一發現它開始沿用某個錯的假設 (變數名寫錯、改到不對的檔案), 不要在同一個對話裡繼續解釋, 直接開新對話. 這比在污染的 context 裡糾正快.
LangChain 的 Lance Martin 把 Context Engineering 的動作分四類. 我把它對應到 Claude Code 的實際指令:
| 動作 | 做什麼 | Claude Code 對應 |
|---|---|---|
| Write | 把資訊寫到 context 外面, 之後再讀 | CLAUDE.md (常駐規則)、agent 主動寫 NOTES.md |
| Select | 需要時才拉進來 | /skill-name 觸發載入、Read 某檔案、Grep |
| Compress | 塞進來的東西壓一壓 | /compact (整輪對話摘要)、/clear (整段砍掉) |
| Isolate | 邊界工作丟到別的 window | Sub-agent、/goal 開子任務、另開一個 Claude Code session |
四招不是選一個, 是一起用. 一個成熟的工作流大概是: 平常靠 CLAUDE.md write 到外面 → 每次任務用 skill select 只拉相關的 → 對話變長就 compact → 髒活丟 sub-agent isolate.
例一: 一個 CLAUDE.md 讓 refactor 從三輪變一輪
沒 CLAUDE.md 時, 你每個檔案都要重貼一次「用 tab 不用 space、結尾空行、commit 用中文」. 寫進 CLAUDE.md 後每輪自動注入, 你只講「refactor 這支」, 它就照 project style 動.
例二: 20 個 MCP 全裝上, 每輪多吃 5K 到 10K tokens
一個 MCP tool 定義平均 200 到 500 tokens. 裝 20 個等於每輪都讀 4K 到 10K 工具定義, 而且模型從 20 個裡挑對的準度會下降. Anthropic 原話: 「人類工程師都無法確定該用哪個, AI agent 也做不到.」實務: MCP 分場景裝.
例三: /compact 跟 /clear 什麼時候各用哪個
/compact: 對話有價值但長度已經吃到效能. 摘要完繼續, 決策脈絡保留/clear: 對話被 poisoned 或任務轉大方向. 整段丟掉, 不要留下前面的錯
大部分人只會 /clear. /compact 是耐心武器, 長任務中間 compact 幾次比每次都 clear 好.
例四: 讓 agent 主動寫 NOTES.md
長跑任務中, 直接叫 agent「把目前進度、待辦、發現寫進 NOTES.md」. 下一次對話開始就 Read NOTES.md, 恢復到中斷處. Anthropic 那隻打 Pokémon 的 agent 靠這招在幾千步之間追進度. 這是 write 的進階用法: 不只寫規則, 讓 agent 寫自己的外部記憶.
例五: 用 sub-agent 隔離髒活
要在整個 repo 找一個特定 pattern, 別在主對話直接 Grep, 每次搜尋結果都會留在 context 裡佔位子. 開 sub-agent 專門去找, 只把結論回主對話. 主 context 保持乾淨. 這是 isolate 的日常用法, 也是 Day 06 「指令與資料分開」的延伸.
上面五個例子都在講 Claude Code. 如果你用的是 web chat (Claude.ai、ChatGPT、Gemini), 沒有 CLAUDE.md、沒有 MCP、沒有 /compact、沒有 sub-agent 指令, 不代表 Context Engineering 用不上. 四招都有對應做法, 只是介面換了:
| 動作 | Web chat 上的做法 |
|---|---|
| Write | Claude Projects Instructions + Knowledge / ChatGPT Custom Instructions / Gemini Gems |
| Select | 上傳前先過濾, 只貼真的需要的段落, 不要整份 doc 丟 |
| Compress | 開新 chat 就等於 /clear. 切換前先叫模型「把目前結論摘要成一段」再貼進新 chat 帶過去 |
| Isolate | 一個主題一個 chat / 一個 Project. 別把工作、學習、旅行塞同一條 |
具體幾條:
CLAUDE.md 的 web chat 版是 Custom Instructions / Project Instructions. Claude Projects 讓你為每個 Project 寫「這個專案的目標、風格、限制」, 每次對話自動注入, 效果跟 CLAUDE.md 一樣/clear, 但點「New Chat」就是最強的 reset. 對話開始歪掉、切主題、或已經很長, 直接開新的比在原對話裡糾正快
| 誤會 | 事實 |
|---|---|
| Context window 200K, 塞滿也沒關係 | 塞到 180K 通常比塞 30K 差, 因為 attention rot |
| MCP 越多能力越強 | 每個 MCP 都吃 context, 而且 tool 選擇準度會下降 |
| 對話越長, AI 越懂我 | 對話越長, attention 越稀. 有明確目標就開新 session |
| Prompt 寫得好就夠了 | Prompt 只有 5% 權重, 另外 95% 你沒動的話, 好 prompt 也救不回來 |
/clear 就是 reset |
/clear 是丟掉對話 context, 但保留了 CLAUDE.md 跟 skills; 不是全 reset |
Prompt 是問句, Context 是它讀的那本書. 問對很好, 但選對書更重要.
Context Engineering 這件事後面幾天會反覆用到. CLAUDE.md、skills、hooks、subagents 都是它的具體實作.


 iThome鐵人賽
 看影片追技術